 桐果云
跨系统数据分析的需求排了两周,真正花在写 SQL 上的时间往往不到一天——剩下的都在等:等排期、等接口开通、等联调、等前端页面排上队。这篇拿一张常见的数据需求工单,把两周拆开看一遍,再看同一个需求在建模画布上是怎么走完的。
时效与口径说明:本文 2026 年 11 月更新,「零代码」指全程在图形界面拖拽完成、不写 SQL 与脚本;除标注实测的数字外,环节时长均为经验估计。
先把结论放在前面:
- 两周里的大头是等待和联调,不是技术难度,这些环节多数能被砍掉。
- 桐果云(Tongo)把数据接入、可视化建模、看板发布放进同一个图形界面:30 多种数据源接进来后,业务人员拖拽连线就能建模型,不写 SQL。
- 「15 分钟完成一个关联分析模型」是单个项目的实测记录,文末交代它的边界条件。
两周排期,时间都花在哪了
工单是这样一张表:业务部门每月要把订单系统、客户管理系统、库存系统三方的数据合成一张经营表,看每个区域当月的成交和存货。信息科接单,按传统路径走一遍,各环节的常见耗时如下:
| 环节 | 传统路径 | 画布路径 |
|---|---|---|
| 口径对齐 | 1–2 天 | 半小时内 |
| 数据接入与联调 | 2–4 天 | 首次约半天,之后复用连接 |
| 关联与清洗开发 | 2–3 天 | 15–30 分钟 |
| 报表页面开发 | 2–3 天 | 拖组件即时可见 |
| 测试与修改 | 1–2 天 | 改节点重跑 |
两列时长都取自我们陪客户实施时的实践观察与经验估计,那个「15 分钟」的实测记录放在文末细说。单看传统路径这一列就能发现问题:写关联逻辑只占 2–3 天,前面等接口、后面等前端、中间穿插的联调返工,才是排期滚到两周的主要原因。这些等待环节有一个共同点——它们都不是在解决「数怎么算」,而是在解决「人和人怎么交接」。交接环节越多,需求排期越不受写代码的人控制。
先把三个系统的表接进来
画布路径的第一步和传统路径一样:把数据接到一个地方。差别在于接入之后不再需要为每张表单独开发接口。
在数据同步模块里添加数据源:Oracle、MySQL、SQL Server、达梦等主流数据库填连接地址和只读账号,勾选要接入的表;Excel 这类文件直接上传。同步方式支持全量和增量,首次接入时配好连接信息和同步周期,之后每次复用,不再重复这一步。
两个实操要点:一是向生产库取数先申请只读账号,把权限审批放在最前面走,不阻塞后面的动作;二是同步频率按需定,月度经营表天级增量就够,不必对业务库做实时抽取,降低对源系统的影响。
没有专职 IT 部门的团队,接入之后谁来建、谁来看,可先看《没有 IT 部门,谁来搭这套数据? 》里的三个角色分工。
画布上把关联和口径一次做掉
接入完成后,打开数据开发模块的建模画布,五个动作走完整个模型:
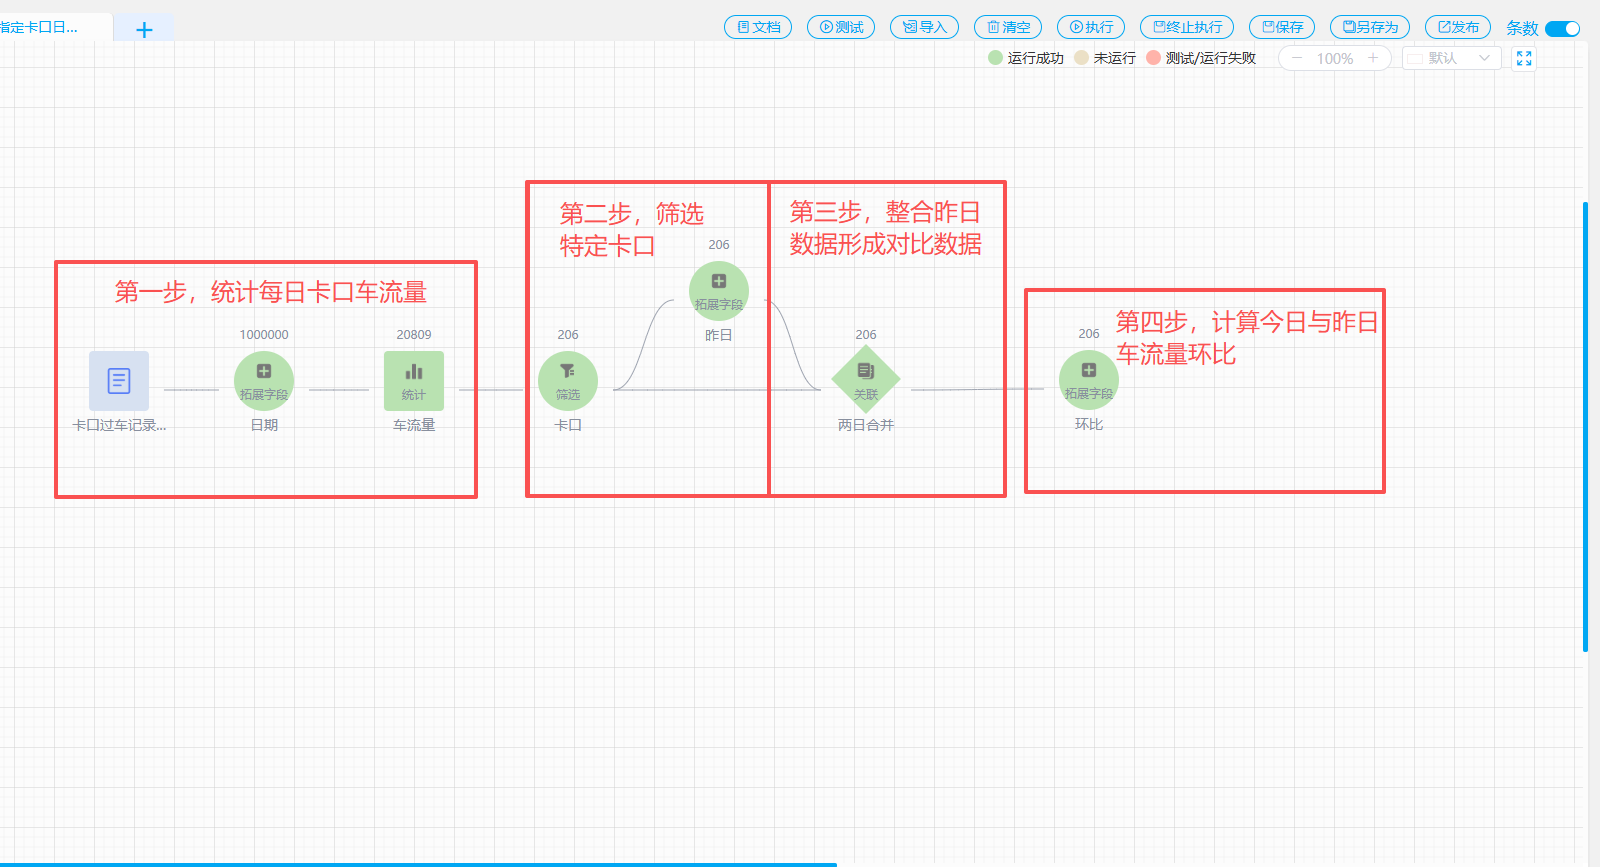
下面这张截图是画布上另一条已经跑通的链路,场景是交通日报:从卡口过车明细表出发,经过按日汇总、筛选、两日合并,最后算出环比。每个节点的中间结果都能单独预览,业务人员核对口径时看的就是这些节点,而不是一段跑完才知道对错的脚本。
口径变了,改一个节点重跑就行
传统路径里口径变化是新一轮排期:改 SQL、改接口、改页面,逐环节回归测试。画布路径里,口径就是画布上的那个节点——按月汇总改成按周,换一个聚合字段重跑;区域划分调整,改一个分组算子的配置;两张表的关联字段有变,重连一根线。
模型本身也是可复用的。这张经营表模型建好之后,下个月不需要重新开发,数据按同步周期自动进来,模型重跑一遍就是当月结果。已固化的口径跟着模型走,新同事接手时看到的是一张画布,而不是一段只有原作者敢动的 SQL。
口径与系统边界的问题如果更复杂——比如 ERP 和 CRM 两边各有一套客户主数据——先读这篇《ERP 和 CRM 对不上,四条路怎么选? 》,里面有四条打通路径的成本对比。
15 分钟的边界:哪些时间要靠管理配合
把实测记录放在最后说清楚。在一个已落地的公安项目里,平台接入了超过 1000 张业务表(项目实施记录),民警在画布上自助搭建了数百个分析模型;其中一个跨三张表的关联分析模型,从拖第一张表到跑出结果,用时 15 分钟(个案实测)。这是实测的边界条件:表结构清晰、关联字段明确、数据源已接入、建模人对口径熟悉。
换一个项目的时长会不一样,有几段时间不归平台管,要靠管理配合:
- 口径对齐的沟通。「成交额含不含退货」这类问题要先说清,工具只能固化口径,定义口径要靠业务和建模人坐下来谈。
- 首次接入生产库的权限审批。这由客户方的管理流程配合完成,走完之后是长期复用的。
- 质量太差的表要先清洗。字段混乱、编码不一的表直接进关联会报错,先做一次去重和标准化,后面的链路才稳。
这些不是平台的短板,而是数据工作本身的功课:把口径做在模型的节点里,把权限流程走在接入之前,画布路径的速度优势才能兑现。综合各项目实施情况,多数跨系统取数需求在数据源接好后,半小时到半天内能走完从建模到看板的全链路(经验估计)。
想自己走一遍这个流程,从零基础建模第一课:从两张表开始 练起,三个练习覆盖选表、关联、聚合。桐果云的完整能力清单见产品页 。
常见问题(FAQ)
跨系统数据分析一般要多久?
传统开发路径从口径对齐、接口联调到报表上线,常见排期一到两周(实践观察);其中真正花在数据关联逻辑上的时间通常不到一天,大头在等待与联调。用画布式建模把接入、关联、看板放进同一个界面后,同类需求多数能在当天出第一版(经验估计)。
桐果云怎么做跨系统数据分析?
先用数据同步模块接入 Oracle、MySQL、SQL Server、达梦、Excel 等 30 多种数据源,再把需要的表拖进建模画布,连线设定关联字段、挂上清洗和汇总算子,逐节点预览后一键发布成看板。全程图形界面拖拽完成,不写 SQL。
不会写 SQL,能把多个系统的表关联起来吗?
能,前提是知道两张表靠哪个字段对应,比如订单表和客户表共有的客户编号。关联字段明确时,拖拽连线、下拉选择即可完成;字段对不上时先做一次映射整理,这一步工具替不掉,需要熟悉业务的人参与。
桐果云接入 Oracle、MySQL 这些数据库要写代码吗?
不用。在数据同步模块里选择数据源类型,填连接地址和只读账号,勾选要接入的表即可,支持全量和增量两种同步方式;Excel 这类文件直接上传映射。后续新增表或调整同步周期,都在同一个界面里操作。